build 6ddc7a35 | content blog-content@417154f · 338 posts | profiles 32 · corpus 315 | ● 0 skipped | format run

$ soultec get service/monitoring -o yaml$ soultec get service/monitoring -o json$ soultec get service/monitoring -o toml$ soultec get service/monitoring -o xml$ python3 monitoring.pyPS> ./monitoring.ps1$ go run monitoring.go$ node monitoring.js

apiVersion: soultec.ch/v1kind: Servicemetadata: name: monitoring locale: de labels: group: support capability/monitoring: 2.44 capability/managed-services: 2.65 annotations: source: src/content/services/de/monitoring.md route: /de/services/monitoring/ schema: /nerd/schema/services.json markdown: /de/services/monitoring.mdspec: title: Monitoring group: support audience: [enterprise, provider] order: 3 tags: [monitoring, managed-services] summary: >- Jedes System kann Alarme senden. Die Kunst ist, sie zueinander in Beziehung zu setzen, statt fünfzig Meldungen für einen Ausfall zu bekommen. photo: monitoring-wall photoNeed: "A monitoring dashboard at 2am tone: dark room, one screen, one person" stub: false draft: false sections: - heading:

Das eigentliche Problem

body: | Jedes Produkt, Hardware wie Software, kann heute Alarme und Meldungen verschicken. Genau das ist die Schwierigkeit: Bei einem einzigen Ausfall melden sich der Host, der Storage, die Datenbank und die Anwendung gleichzeitig, und in dieser Menge geht die eine Meldung unter, die die Ursache benennt. - heading:

Was eine Monitoring-Infrastruktur leisten muss

body: | Sie besteht aus Sendern und Empfängern, und ihre Aufgabe ist die Korrelation: Meldungen zueinander in Beziehung setzen, damit aus fünfzig Ereignissen ein Vorfall wird. Erst dann ist eine Analyse überhaupt möglich. - heading:

Zwei Arten, und beide werden gebraucht

body: | **Proaktives Monitoring** meldet den Trend, der zum Ausfall führt, und verhindert ihn damit überhaupt erst. Es sind meist die cloudbasierten Lösungen der Hersteller, die deine Umgebung gegen Fehlerbilder aus sehr vielen anderen Installationen halten. **Reaktives Monitoring** meldet, dass etwas kaputt ist. Das sind meist die On-Premises-Systeme, und sie sind der Teil, auf den die Alarmierung aufsetzt. Wer nur das zweite betreibt, erfährt zuverlässig vom Ausfall. Wer beides betreibt, erfährt vorher davon. - heading:

Was dazugehört

body: | Überwacht werden Hardware, Anwendungen, Services und Netzwerke, rund um die Uhr und ohne Agenten auf den Systemen. Ein Dashboard zeigt den Zustand der Infrastruktur, die Alarmierung geht per E-Mail und SMS, und ein Alarm eröffnet automatisch ein Ticket beim Service Desk und, wo nötig, beim Hersteller. - heading:

Womit

body: | Mit den Produkten unserer Partner, oder mit Open-Source-Produkten, wenn die besser passen. Was passt, hängt davon ab, welche Schnittstellen deine Systeme schon bedienen. - heading:

Worauf zu achten ist

body: | Vor der Einführung klären wir, welche Meldung wen erreicht und was daraufhin passiert. Alarme ohne festgelegte Reaktion werden nach kurzer Zeit ignoriert, und dann fehlen sie im Ernstfall.status: corpus: 315 solutions: - {ref: solutions/omnissa/workspace-one/workspace-one-assist, score: 0.42} - {ref: solutions/vmware/vmware-cloud-service-provider, score: 0.41} - {ref: solutions/vmware/vmware-cloud-foundation/addon/business-operations, score: 0.40} - {ref: solutions/omnissa/workspace-one/addon/omnissa-intelligence-addon, score: 0.40} alsoLike: - {ref: services/managed-service, score: 1.00} - {ref: services/managed-security, score: 0.52} - {ref: posts/infrastructure-assessment-mit-hpe-cloudphysics, score: 0.49} experts: - {ref: experts/valentina-cicmak, score: 0.42} - {ref: experts/mike-schmid, score: 0.33} - {ref: experts/matthias-frech, score: 0.32} search: /de/search.json
{ "apiVersion": "soultec.ch/v1", "kind": "Service", "metadata": { "name": "monitoring", "locale": "de", "labels": { "group": "support", "capability/monitoring": 2.44, "capability/managed-services": 2.65 }, "annotations": { "source": "src/content/services/de/monitoring.md", "route": "/de/services/monitoring/", "schema": "/nerd/schema/services.json", "markdown": "/de/services/monitoring.md" } }, "spec": { "title": "Monitoring", "group": "support", "audience": [ "enterprise", "provider" ], "order": 3, "tags": [ "monitoring", "managed-services" ], "summary": "Jedes System kann Alarme senden. Die Kunst ist, sie zueinander in Beziehung zu setzen, statt fünfzig Meldungen für einen Ausfall zu bekommen.", "photo": "monitoring-wall", "photoNeed": "A monitoring dashboard at 2am tone: dark room, one screen, one person", "stub": false, "draft": false, "sections": [ { "heading": "

Das eigentliche Problem

",
"body": "Jedes Produkt, Hardware wie Software, kann heute Alarme und Meldungen verschicken. Genau\ndas ist die Schwierigkeit: Bei einem einzigen Ausfall melden sich der Host, der Storage,\ndie Datenbank und die Anwendung gleichzeitig, und in dieser Menge geht die eine Meldung\nunter, die die Ursache benennt." }, { "heading": "

Was eine Monitoring-Infrastruktur leisten muss

",
"body": "Sie besteht aus Sendern und Empfängern, und ihre Aufgabe ist die Korrelation: Meldungen\nzueinander in Beziehung setzen, damit aus fünfzig Ereignissen ein Vorfall wird. Erst dann\nist eine Analyse überhaupt möglich." }, { "heading": "

Zwei Arten, und beide werden gebraucht

",
"body": "**Proaktives Monitoring** meldet den Trend, der zum Ausfall führt, und verhindert ihn\ndamit überhaupt erst. Es sind meist die cloudbasierten Lösungen der Hersteller, die deine\nUmgebung gegen Fehlerbilder aus sehr vielen anderen Installationen halten.\n\n**Reaktives Monitoring** meldet, dass etwas kaputt ist. Das sind meist die\nOn-Premises-Systeme, und sie sind der Teil, auf den die Alarmierung aufsetzt.\n\nWer nur das zweite betreibt, erfährt zuverlässig vom Ausfall. Wer beides betreibt,\nerfährt vorher davon." }, { "heading": "

Was dazugehört

",
"body": "Überwacht werden Hardware, Anwendungen, Services und Netzwerke, rund um die Uhr und ohne\nAgenten auf den Systemen. Ein Dashboard zeigt den Zustand der Infrastruktur, die Alarmierung\ngeht per E-Mail und SMS, und ein Alarm eröffnet automatisch ein Ticket beim Service Desk\nund, wo nötig, beim Hersteller." }, { "heading": "

Womit

",
"body": "Mit den Produkten unserer Partner, oder mit Open-Source-Produkten, wenn die besser passen.\nWas passt, hängt davon ab, welche Schnittstellen deine Systeme schon bedienen." }, { "heading": "

Worauf zu achten ist

",
"body": "Vor der Einführung klären wir, welche Meldung wen erreicht und was daraufhin passiert.\nAlarme ohne festgelegte Reaktion werden nach kurzer Zeit ignoriert, und dann fehlen sie im\nErnstfall." } ] }, "status": { "corpus": 315, "solutions": [ { "ref": "solutions/omnissa/workspace-one/workspace-one-assist", "score": "0.42" }, { "ref": "solutions/vmware/vmware-cloud-service-provider", "score": "0.41" }, { "ref": "solutions/vmware/vmware-cloud-foundation/addon/business-operations", "score": "0.40" }, { "ref": "solutions/omnissa/workspace-one/addon/omnissa-intelligence-addon", "score": "0.40" } ], "alsoLike": [ { "ref": "services/managed-service", "score": "1.00" }, { "ref": "services/managed-security", "score": "0.52" }, { "ref": "posts/infrastructure-assessment-mit-hpe-cloudphysics", "score": "0.49" } ], "experts": [ { "ref": "experts/valentina-cicmak", "score": "0.42" }, { "ref": "experts/mike-schmid", "score": "0.33" }, { "ref": "experts/matthias-frech", "score": "0.32" } ], "search": "/de/search.json" }}
apiVersion = "soultec.ch/v1"kind = "Service"[metadata]name = "monitoring"locale = "de"[metadata.labels]group = "support""capability/monitoring" = 2.44"capability/managed-services" = 2.65[metadata.annotations]source = "src/content/services/de/monitoring.md"route = "/de/services/monitoring/"schema = "/nerd/schema/services.json"markdown = "/de/services/monitoring.md"[spec]title = "Monitoring"group = "support"audience = ["enterprise", "provider"]order = 3tags = ["monitoring", "managed-services"]summary = "Jedes System kann Alarme senden. Die Kunst ist, sie zueinander in Beziehung zu setzen, statt fünfzig Meldungen für einen Ausfall zu bekommen."photo = "monitoring-wall"photoNeed = "A monitoring dashboard at 2am tone: dark room, one screen, one person"stub = falsedraft = false[[spec.sections]]heading = "

Das eigentliche Problem

"
body = '''Jedes Produkt, Hardware wie Software, kann heute Alarme und Meldungen verschicken. Genaudas ist die Schwierigkeit: Bei einem einzigen Ausfall melden sich der Host, der Storage,die Datenbank und die Anwendung gleichzeitig, und in dieser Menge geht die eine Meldungunter, die die Ursache benennt.'''[[spec.sections]]heading = "

Was eine Monitoring-Infrastruktur leisten muss

"
body = '''Sie besteht aus Sendern und Empfängern, und ihre Aufgabe ist die Korrelation: Meldungenzueinander in Beziehung setzen, damit aus fünfzig Ereignissen ein Vorfall wird. Erst dannist eine Analyse überhaupt möglich.'''[[spec.sections]]heading = "

Zwei Arten, und beide werden gebraucht

"
body = '''**Proaktives Monitoring** meldet den Trend, der zum Ausfall führt, und verhindert ihndamit überhaupt erst. Es sind meist die cloudbasierten Lösungen der Hersteller, die deineUmgebung gegen Fehlerbilder aus sehr vielen anderen Installationen halten.**Reaktives Monitoring** meldet, dass etwas kaputt ist. Das sind meist dieOn-Premises-Systeme, und sie sind der Teil, auf den die Alarmierung aufsetzt.Wer nur das zweite betreibt, erfährt zuverlässig vom Ausfall. Wer beides betreibt,erfährt vorher davon.'''[[spec.sections]]heading = "

Was dazugehört

"
body = '''Überwacht werden Hardware, Anwendungen, Services und Netzwerke, rund um die Uhr und ohneAgenten auf den Systemen. Ein Dashboard zeigt den Zustand der Infrastruktur, die Alarmierunggeht per E-Mail und SMS, und ein Alarm eröffnet automatisch ein Ticket beim Service Deskund, wo nötig, beim Hersteller.'''[[spec.sections]]heading = "

Womit

"
body = '''Mit den Produkten unserer Partner, oder mit Open-Source-Produkten, wenn die besser passen.Was passt, hängt davon ab, welche Schnittstellen deine Systeme schon bedienen.'''[[spec.sections]]heading = "

Worauf zu achten ist

"
body = '''Vor der Einführung klären wir, welche Meldung wen erreicht und was daraufhin passiert.Alarme ohne festgelegte Reaktion werden nach kurzer Zeit ignoriert, und dann fehlen sie imErnstfall.'''[status]corpus = 315search = "/de/search.json"[[status.solutions]]ref = "solutions/omnissa/workspace-one/workspace-one-assist"score = "0.42"[[status.solutions]]ref = "solutions/vmware/vmware-cloud-service-provider"score = "0.41"[[status.solutions]]ref = "solutions/vmware/vmware-cloud-foundation/addon/business-operations"score = "0.40"[[status.solutions]]ref = "solutions/omnissa/workspace-one/addon/omnissa-intelligence-addon"score = "0.40"[[status.alsoLike]]ref = "services/managed-service"score = "1.00"[[status.alsoLike]]ref = "services/managed-security"score = "0.52"[[status.alsoLike]]ref = "posts/infrastructure-assessment-mit-hpe-cloudphysics"score = "0.49"[[status.experts]]ref = "experts/valentina-cicmak"score = "0.42"[[status.experts]]ref = "experts/mike-schmid"score = "0.33"[[status.experts]]ref = "experts/matthias-frech"score = "0.32"
<?xml version="1.0" encoding="UTF-8"?><manifest kind="Service"> <apiVersion>soultec.ch/v1</apiVersion> <metadata> <name>monitoring</name> <locale>de</locale> <labels> <group>support</group> <entry key="capability/monitoring">2.44</entry> <entry key="capability/managed-services">2.65</entry> </labels> <annotations> <source>src/content/services/de/monitoring.md</source> <route>/de/services/monitoring/</route> <schema>/nerd/schema/services.json</schema> <markdown>/de/services/monitoring.md</markdown> </annotations> </metadata> <spec> <title>Monitoring</title> <group>support</group> <audience> <item>enterprise</item> <item>provider</item> </audience> <order>3</order> <tags> <item>monitoring</item> <item>managed-services</item> </tags> <summary>Jedes System kann Alarme senden. Die Kunst ist, sie zueinander in Beziehung zu setzen, statt fünfzig Meldungen für einen Ausfall zu bekommen.</summary> <photo>monitoring-wall</photo> <photoNeed>A monitoring dashboard at 2am tone: dark room, one screen, one person</photoNeed> <stub>false</stub> <draft>false</draft> <sections> <section> <heading>

Das eigentliche Problem

</heading>
<body>Jedes Produkt, Hardware wie Software, kann heute Alarme und Meldungen verschicken. Genaudas ist die Schwierigkeit: Bei einem einzigen Ausfall melden sich der Host, der Storage,die Datenbank und die Anwendung gleichzeitig, und in dieser Menge geht die eine Meldungunter, die die Ursache benennt. </body> </section> <section> <heading>

Was eine Monitoring-Infrastruktur leisten muss

</heading>
<body>Sie besteht aus Sendern und Empfängern, und ihre Aufgabe ist die Korrelation: Meldungenzueinander in Beziehung setzen, damit aus fünfzig Ereignissen ein Vorfall wird. Erst dannist eine Analyse überhaupt möglich. </body> </section> <section> <heading>

Zwei Arten, und beide werden gebraucht

</heading>
<body>**Proaktives Monitoring** meldet den Trend, der zum Ausfall führt, und verhindert ihndamit überhaupt erst. Es sind meist die cloudbasierten Lösungen der Hersteller, die deineUmgebung gegen Fehlerbilder aus sehr vielen anderen Installationen halten.**Reaktives Monitoring** meldet, dass etwas kaputt ist. Das sind meist dieOn-Premises-Systeme, und sie sind der Teil, auf den die Alarmierung aufsetzt.Wer nur das zweite betreibt, erfährt zuverlässig vom Ausfall. Wer beides betreibt,erfährt vorher davon. </body> </section> <section> <heading>

Was dazugehört

</heading>
<body>Überwacht werden Hardware, Anwendungen, Services und Netzwerke, rund um die Uhr und ohneAgenten auf den Systemen. Ein Dashboard zeigt den Zustand der Infrastruktur, die Alarmierunggeht per E-Mail und SMS, und ein Alarm eröffnet automatisch ein Ticket beim Service Deskund, wo nötig, beim Hersteller. </body> </section> <section> <heading>

Womit

</heading>
<body>Mit den Produkten unserer Partner, oder mit Open-Source-Produkten, wenn die besser passen.Was passt, hängt davon ab, welche Schnittstellen deine Systeme schon bedienen. </body> </section> <section> <heading>

Worauf zu achten ist

</heading>
<body>Vor der Einführung klären wir, welche Meldung wen erreicht und was daraufhin passiert.Alarme ohne festgelegte Reaktion werden nach kurzer Zeit ignoriert, und dann fehlen sie imErnstfall. </body> </section> </sections> </spec> <status> <corpus>315</corpus> <solutions> <item> <ref>solutions/omnissa/workspace-one/workspace-one-assist</ref> <score>0.42</score> </item> <item> <ref>solutions/vmware/vmware-cloud-service-provider</ref> <score>0.41</score> </item> <item> <ref>solutions/vmware/vmware-cloud-foundation/addon/business-operations</ref> <score>0.40</score> </item> <item> <ref>solutions/omnissa/workspace-one/addon/omnissa-intelligence-addon</ref> <score>0.40</score> </item> </solutions> <alsoLike> <item> <ref>services/managed-service</ref> <score>1.00</score> </item> <item> <ref>services/managed-security</ref> <score>0.52</score> </item> <item> <ref>posts/infrastructure-assessment-mit-hpe-cloudphysics</ref> <score>0.49</score> </item> </alsoLike> <experts> <item> <ref>experts/valentina-cicmak</ref> <score>0.42</score> </item> <item> <ref>experts/mike-schmid</ref> <score>0.33</score> </item> <item> <ref>experts/matthias-frech</ref> <score>0.32</score> </item> </experts> <search>/de/search.json</search> </status></manifest>
# Code generated by the soultec.ch build. DO NOT EDIT.import jsonPAGE = { "apiVersion": "soultec.ch/v1", "kind": "Service", "metadata": { "name": "monitoring", "locale": "de", "labels": { "group": "support", "capability/monitoring": 2.44, "capability/managed-services": 2.65, }, "annotations": { "source": "src/content/services/de/monitoring.md", "route": "/de/services/monitoring/", "schema": "/nerd/schema/services.json", "markdown": "/de/services/monitoring.md", }, }, "spec": { "title": "Monitoring", "group": "support", "audience": ["enterprise", "provider"], "order": 3, "tags": ["monitoring", "managed-services"], "summary": "Jedes System kann Alarme senden. Die Kunst ist, sie zueinander in Beziehung zu setzen, statt fünfzig Meldungen für einen Ausfall zu bekommen.", "photo": "monitoring-wall", "photoNeed": "A monitoring dashboard at 2am tone: dark room, one screen, one person", "stub": False, "draft": False, "sections": [ { "heading": "

Das eigentliche Problem

",
"body": ( "Jedes Produkt, Hardware wie Software, kann heute Alarme und Meldungen verschicken. Genau\n" "das ist die Schwierigkeit: Bei einem einzigen Ausfall melden sich der Host, der Storage,\n" "die Datenbank und die Anwendung gleichzeitig, und in dieser Menge geht die eine Meldung\n" "unter, die die Ursache benennt." ), }, { "heading": "

Was eine Monitoring-Infrastruktur leisten muss

",
"body": ( "Sie besteht aus Sendern und Empfängern, und ihre Aufgabe ist die Korrelation: Meldungen\n" "zueinander in Beziehung setzen, damit aus fünfzig Ereignissen ein Vorfall wird. Erst dann\n" "ist eine Analyse überhaupt möglich." ), }, { "heading": "

Zwei Arten, und beide werden gebraucht

",
"body": ( "**Proaktives Monitoring** meldet den Trend, der zum Ausfall führt, und verhindert ihn\n" "damit überhaupt erst. Es sind meist die cloudbasierten Lösungen der Hersteller, die deine\n" "Umgebung gegen Fehlerbilder aus sehr vielen anderen Installationen halten.\n" "\n" "**Reaktives Monitoring** meldet, dass etwas kaputt ist. Das sind meist die\n" "On-Premises-Systeme, und sie sind der Teil, auf den die Alarmierung aufsetzt.\n" "\n" "Wer nur das zweite betreibt, erfährt zuverlässig vom Ausfall. Wer beides betreibt,\n" "erfährt vorher davon." ), }, { "heading": "

Was dazugehört

",
"body": ( "Überwacht werden Hardware, Anwendungen, Services und Netzwerke, rund um die Uhr und ohne\n" "Agenten auf den Systemen. Ein Dashboard zeigt den Zustand der Infrastruktur, die Alarmierung\n" "geht per E-Mail und SMS, und ein Alarm eröffnet automatisch ein Ticket beim Service Desk\n" "und, wo nötig, beim Hersteller." ), }, { "heading": "

Womit

",
"body": ( "Mit den Produkten unserer Partner, oder mit Open-Source-Produkten, wenn die besser passen.\n" "Was passt, hängt davon ab, welche Schnittstellen deine Systeme schon bedienen." ), }, { "heading": "

Worauf zu achten ist

",
"body": ( "Vor der Einführung klären wir, welche Meldung wen erreicht und was daraufhin passiert.\n" "Alarme ohne festgelegte Reaktion werden nach kurzer Zeit ignoriert, und dann fehlen sie im\n" "Ernstfall." ), }, ], }, "status": { "corpus": 315, "solutions": [ { "ref": "solutions/omnissa/workspace-one/workspace-one-assist", "score": "0.42", }, { "ref": "solutions/vmware/vmware-cloud-service-provider", "score": "0.41", }, { "ref": "solutions/vmware/vmware-cloud-foundation/addon/business-operations", "score": "0.40", }, { "ref": "solutions/omnissa/workspace-one/addon/omnissa-intelligence-addon", "score": "0.40", }, ], "alsoLike": [ { "ref": "services/managed-service", "score": "1.00", }, { "ref": "services/managed-security", "score": "0.52", }, { "ref": "posts/infrastructure-assessment-mit-hpe-cloudphysics", "score": "0.49", }, ], "experts": [ { "ref": "experts/valentina-cicmak", "score": "0.42", }, { "ref": "experts/mike-schmid", "score": "0.33", }, { "ref": "experts/matthias-frech", "score": "0.32", }, ], "search": "/de/search.json", },}if __name__ == "__main__": print(json.dumps(PAGE, indent=2, ensure_ascii=False))
# Code generated by the soultec.ch build. DO NOT EDIT.$Page = [ordered]@{ apiVersion = 'soultec.ch/v1' kind = 'Service' metadata = [ordered]@{ name = 'monitoring' locale = 'de' labels = [ordered]@{ group = 'support' 'capability/monitoring' = 2.44 'capability/managed-services' = 2.65 } annotations = [ordered]@{ source = 'src/content/services/de/monitoring.md' route = '/de/services/monitoring/' schema = '/nerd/schema/services.json' markdown = '/de/services/monitoring.md' } } spec = [ordered]@{ title = 'Monitoring' group = 'support' audience = @('enterprise', 'provider') order = 3 tags = @('monitoring', 'managed-services') summary = 'Jedes System kann Alarme senden. Die Kunst ist, sie zueinander in Beziehung zu setzen, statt fünfzig Meldungen für einen Ausfall zu bekommen.' photo = 'monitoring-wall' photoNeed = 'A monitoring dashboard at 2am tone: dark room, one screen, one person' stub = $false draft = $false sections = @( [ordered]@{ heading = '

Das eigentliche Problem

'
body = @'Jedes Produkt, Hardware wie Software, kann heute Alarme und Meldungen verschicken. Genaudas ist die Schwierigkeit: Bei einem einzigen Ausfall melden sich der Host, der Storage,die Datenbank und die Anwendung gleichzeitig, und in dieser Menge geht die eine Meldungunter, die die Ursache benennt.'@ } [ordered]@{ heading = '

Was eine Monitoring-Infrastruktur leisten muss

'
body = @'Sie besteht aus Sendern und Empfängern, und ihre Aufgabe ist die Korrelation: Meldungenzueinander in Beziehung setzen, damit aus fünfzig Ereignissen ein Vorfall wird. Erst dannist eine Analyse überhaupt möglich.'@ } [ordered]@{ heading = '

Zwei Arten, und beide werden gebraucht

'
body = @'**Proaktives Monitoring** meldet den Trend, der zum Ausfall führt, und verhindert ihndamit überhaupt erst. Es sind meist die cloudbasierten Lösungen der Hersteller, die deineUmgebung gegen Fehlerbilder aus sehr vielen anderen Installationen halten.**Reaktives Monitoring** meldet, dass etwas kaputt ist. Das sind meist dieOn-Premises-Systeme, und sie sind der Teil, auf den die Alarmierung aufsetzt.Wer nur das zweite betreibt, erfährt zuverlässig vom Ausfall. Wer beides betreibt,erfährt vorher davon.'@ } [ordered]@{ heading = '

Was dazugehört

'
body = @'Überwacht werden Hardware, Anwendungen, Services und Netzwerke, rund um die Uhr und ohneAgenten auf den Systemen. Ein Dashboard zeigt den Zustand der Infrastruktur, die Alarmierunggeht per E-Mail und SMS, und ein Alarm eröffnet automatisch ein Ticket beim Service Deskund, wo nötig, beim Hersteller.'@ } [ordered]@{ heading = '

Womit

'
body = @'Mit den Produkten unserer Partner, oder mit Open-Source-Produkten, wenn die besser passen.Was passt, hängt davon ab, welche Schnittstellen deine Systeme schon bedienen.'@ } [ordered]@{ heading = '

Worauf zu achten ist

'
body = @'Vor der Einführung klären wir, welche Meldung wen erreicht und was daraufhin passiert.Alarme ohne festgelegte Reaktion werden nach kurzer Zeit ignoriert, und dann fehlen sie imErnstfall.'@ } ) } status = [ordered]@{ corpus = 315 solutions = @( [ordered]@{ ref = 'solutions/omnissa/workspace-one/workspace-one-assist' score = '0.42' } [ordered]@{ ref = 'solutions/vmware/vmware-cloud-service-provider' score = '0.41' } [ordered]@{ ref = 'solutions/vmware/vmware-cloud-foundation/addon/business-operations' score = '0.40' } [ordered]@{ ref = 'solutions/omnissa/workspace-one/addon/omnissa-intelligence-addon' score = '0.40' } ) alsoLike = @( [ordered]@{ ref = 'services/managed-service' score = '1.00' } [ordered]@{ ref = 'services/managed-security' score = '0.52' } [ordered]@{ ref = 'posts/infrastructure-assessment-mit-hpe-cloudphysics' score = '0.49' } ) experts = @( [ordered]@{ ref = 'experts/valentina-cicmak' score = '0.42' } [ordered]@{ ref = 'experts/mike-schmid' score = '0.33' } [ordered]@{ ref = 'experts/matthias-frech' score = '0.32' } ) search = '/de/search.json' }}$Page | ConvertTo-Json -Depth 32
// Code generated by the soultec.ch build. DO NOT EDIT.package mainimport ( "encoding/json" "os")var page = map[string]any{ "apiVersion": "soultec.ch/v1", "kind": "Service", "metadata": map[string]any{ "name": "monitoring", "locale": "de", "labels": map[string]any{ "group": "support", "capability/monitoring": 2.44, "capability/managed-services": 2.65, }, "annotations": map[string]any{ "source": "src/content/services/de/monitoring.md", "route": "/de/services/monitoring/", "schema": "/nerd/schema/services.json", "markdown": "/de/services/monitoring.md", }, }, "spec": map[string]any{ "title": "Monitoring", "group": "support", "audience": []any{"enterprise", "provider"}, "order": 3, "tags": []any{"monitoring", "managed-services"}, "summary": "Jedes System kann Alarme senden. Die Kunst ist, sie zueinander in Beziehung zu setzen, statt fünfzig Meldungen für einen Ausfall zu bekommen.", "photo": "monitoring-wall", "photoNeed": "A monitoring dashboard at 2am tone: dark room, one screen, one person", "stub": false, "draft": false, "sections": []any{ map[string]any{ "heading": "

Das eigentliche Problem

",
"body": "Jedes Produkt, Hardware wie Software, kann heute Alarme und Meldungen verschicken. Genau\n" + "das ist die Schwierigkeit: Bei einem einzigen Ausfall melden sich der Host, der Storage,\n" + "die Datenbank und die Anwendung gleichzeitig, und in dieser Menge geht die eine Meldung\n" + "unter, die die Ursache benennt.", }, map[string]any{ "heading": "

Was eine Monitoring-Infrastruktur leisten muss

",
"body": "Sie besteht aus Sendern und Empfängern, und ihre Aufgabe ist die Korrelation: Meldungen\n" + "zueinander in Beziehung setzen, damit aus fünfzig Ereignissen ein Vorfall wird. Erst dann\n" + "ist eine Analyse überhaupt möglich.", }, map[string]any{ "heading": "

Zwei Arten, und beide werden gebraucht

",
"body": "**Proaktives Monitoring** meldet den Trend, der zum Ausfall führt, und verhindert ihn\n" + "damit überhaupt erst. Es sind meist die cloudbasierten Lösungen der Hersteller, die deine\n" + "Umgebung gegen Fehlerbilder aus sehr vielen anderen Installationen halten.\n" + "\n" + "**Reaktives Monitoring** meldet, dass etwas kaputt ist. Das sind meist die\n" + "On-Premises-Systeme, und sie sind der Teil, auf den die Alarmierung aufsetzt.\n" + "\n" + "Wer nur das zweite betreibt, erfährt zuverlässig vom Ausfall. Wer beides betreibt,\n" + "erfährt vorher davon.", }, map[string]any{ "heading": "

Was dazugehört

",
"body": "Überwacht werden Hardware, Anwendungen, Services und Netzwerke, rund um die Uhr und ohne\n" + "Agenten auf den Systemen. Ein Dashboard zeigt den Zustand der Infrastruktur, die Alarmierung\n" + "geht per E-Mail und SMS, und ein Alarm eröffnet automatisch ein Ticket beim Service Desk\n" + "und, wo nötig, beim Hersteller.", }, map[string]any{ "heading": "

Womit

",
"body": "Mit den Produkten unserer Partner, oder mit Open-Source-Produkten, wenn die besser passen.\n" + "Was passt, hängt davon ab, welche Schnittstellen deine Systeme schon bedienen.", }, map[string]any{ "heading": "

Worauf zu achten ist

",
"body": "Vor der Einführung klären wir, welche Meldung wen erreicht und was daraufhin passiert.\n" + "Alarme ohne festgelegte Reaktion werden nach kurzer Zeit ignoriert, und dann fehlen sie im\n" + "Ernstfall.", }, }, }, "status": map[string]any{ "corpus": 315, "solutions": []any{ map[string]any{ "ref": "solutions/omnissa/workspace-one/workspace-one-assist", "score": "0.42", }, map[string]any{ "ref": "solutions/vmware/vmware-cloud-service-provider", "score": "0.41", }, map[string]any{ "ref": "solutions/vmware/vmware-cloud-foundation/addon/business-operations", "score": "0.40", }, map[string]any{ "ref": "solutions/omnissa/workspace-one/addon/omnissa-intelligence-addon", "score": "0.40", }, }, "alsoLike": []any{ map[string]any{ "ref": "services/managed-service", "score": "1.00", }, map[string]any{ "ref": "services/managed-security", "score": "0.52", }, map[string]any{ "ref": "posts/infrastructure-assessment-mit-hpe-cloudphysics", "score": "0.49", }, }, "experts": []any{ map[string]any{ "ref": "experts/valentina-cicmak", "score": "0.42", }, map[string]any{ "ref": "experts/mike-schmid", "score": "0.33", }, map[string]any{ "ref": "experts/matthias-frech", "score": "0.32", }, }, "search": "/de/search.json", },}func main() { enc := json.NewEncoder(os.Stdout) enc.SetEscapeHTML(false) enc.SetIndent("", " ") if err := enc.Encode(page); err != nil { os.Exit(1) }}
// Code generated by the soultec.ch build. DO NOT EDIT.const page = { apiVersion: "soultec.ch/v1", kind: "Service", metadata: { name: "monitoring", locale: "de", labels: { group: "support", "capability/monitoring": 2.44, "capability/managed-services": 2.65, }, annotations: { source: "src/content/services/de/monitoring.md", route: "/de/services/monitoring/", schema: "/nerd/schema/services.json", markdown: "/de/services/monitoring.md", }, }, spec: { title: "Monitoring", group: "support", audience: ["enterprise", "provider"], order: 3, tags: ["monitoring", "managed-services"], summary: "Jedes System kann Alarme senden. Die Kunst ist, sie zueinander in Beziehung zu setzen, statt fünfzig Meldungen für einen Ausfall zu bekommen.", photo: "monitoring-wall", photoNeed: "A monitoring dashboard at 2am tone: dark room, one screen, one person", stub: false, draft: false, sections: [ { heading: "

Das eigentliche Problem

",
body: "Jedes Produkt, Hardware wie Software, kann heute Alarme und Meldungen verschicken. Genau\n" + "das ist die Schwierigkeit: Bei einem einzigen Ausfall melden sich der Host, der Storage,\n" + "die Datenbank und die Anwendung gleichzeitig, und in dieser Menge geht die eine Meldung\n" + "unter, die die Ursache benennt.", }, { heading: "

Was eine Monitoring-Infrastruktur leisten muss

",
body: "Sie besteht aus Sendern und Empfängern, und ihre Aufgabe ist die Korrelation: Meldungen\n" + "zueinander in Beziehung setzen, damit aus fünfzig Ereignissen ein Vorfall wird. Erst dann\n" + "ist eine Analyse überhaupt möglich.", }, { heading: "

Zwei Arten, und beide werden gebraucht

",
body: "**Proaktives Monitoring** meldet den Trend, der zum Ausfall führt, und verhindert ihn\n" + "damit überhaupt erst. Es sind meist die cloudbasierten Lösungen der Hersteller, die deine\n" + "Umgebung gegen Fehlerbilder aus sehr vielen anderen Installationen halten.\n" + "\n" + "**Reaktives Monitoring** meldet, dass etwas kaputt ist. Das sind meist die\n" + "On-Premises-Systeme, und sie sind der Teil, auf den die Alarmierung aufsetzt.\n" + "\n" + "Wer nur das zweite betreibt, erfährt zuverlässig vom Ausfall. Wer beides betreibt,\n" + "erfährt vorher davon.", }, { heading: "

Was dazugehört

",
body: "Überwacht werden Hardware, Anwendungen, Services und Netzwerke, rund um die Uhr und ohne\n" + "Agenten auf den Systemen. Ein Dashboard zeigt den Zustand der Infrastruktur, die Alarmierung\n" + "geht per E-Mail und SMS, und ein Alarm eröffnet automatisch ein Ticket beim Service Desk\n" + "und, wo nötig, beim Hersteller.", }, { heading: "

Womit

",
body: "Mit den Produkten unserer Partner, oder mit Open-Source-Produkten, wenn die besser passen.\n" + "Was passt, hängt davon ab, welche Schnittstellen deine Systeme schon bedienen.", }, { heading: "

Worauf zu achten ist

",
body: "Vor der Einführung klären wir, welche Meldung wen erreicht und was daraufhin passiert.\n" + "Alarme ohne festgelegte Reaktion werden nach kurzer Zeit ignoriert, und dann fehlen sie im\n" + "Ernstfall.", }, ], }, status: { corpus: 315, solutions: [ { ref: "solutions/omnissa/workspace-one/workspace-one-assist", score: "0.42", }, { ref: "solutions/vmware/vmware-cloud-service-provider", score: "0.41", }, { ref: "solutions/vmware/vmware-cloud-foundation/addon/business-operations", score: "0.40", }, { ref: "solutions/omnissa/workspace-one/addon/omnissa-intelligence-addon", score: "0.40", }, ], alsoLike: [ { ref: "services/managed-service", score: "1.00", }, { ref: "services/managed-security", score: "0.52", }, { ref: "posts/infrastructure-assessment-mit-hpe-cloudphysics", score: "0.49", }, ], experts: [ { ref: "experts/valentina-cicmak", score: "0.42", }, { ref: "experts/mike-schmid", score: "0.33", }, { ref: "experts/matthias-frech", score: "0.32", }, ], search: "/de/search.json", },};console.log(JSON.stringify(page, null, 2));

# 81 lines · YAML · validated at build# 113 lines · JSON · validated at build# 128 lines · TOML · validated at build# 144 lines · XML · validated at build# 144 lines · Python · read back at build, equals the JSON record# 141 lines · PowerShell · read back at build, equals the JSON record# 144 lines · Go · read back at build, equals the JSON record# 129 lines · JavaScript · read back at build, equals the JSON record · served at /de/services/monitoring.md

Service · support

Monitoring

Jedes System kann Alarme senden. Die Kunst ist, sie zueinander in Beziehung zu setzen, statt fünfzig Meldungen für einen Ausfall zu bekommen.

04Lösungen
02Fähigkeiten
315Korpus
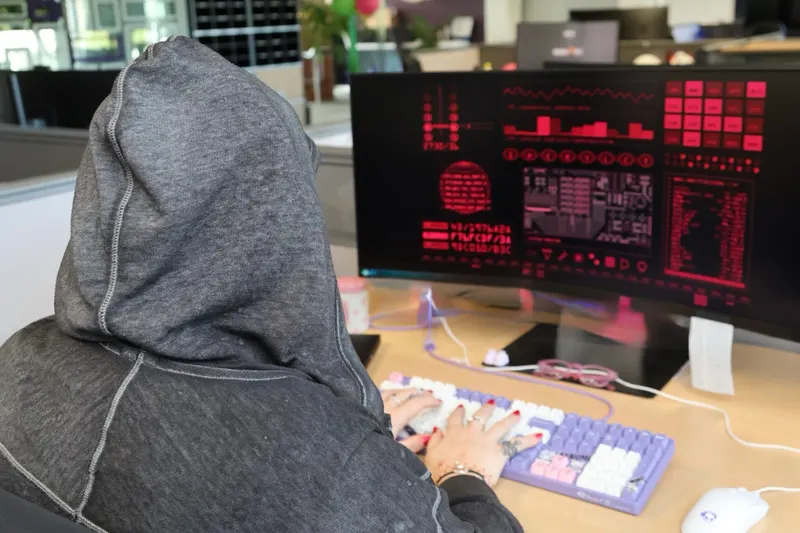
An engineer reading a monitoring dashboard on a dark screen

Das eigentliche Problem

Jedes Produkt, Hardware wie Software, kann heute Alarme und Meldungen verschicken. Genau das ist die Schwierigkeit: Bei einem einzigen Ausfall melden sich der Host, der Storage, die Datenbank und die Anwendung gleichzeitig, und in dieser Menge geht die eine Meldung unter, die die Ursache benennt.

Was eine Monitoring-Infrastruktur leisten muss

Sie besteht aus Sendern und Empfängern, und ihre Aufgabe ist die Korrelation: Meldungen zueinander in Beziehung setzen, damit aus fünfzig Ereignissen ein Vorfall wird. Erst dann ist eine Analyse überhaupt möglich.

Zwei Arten, und beide werden gebraucht

Proaktives Monitoring meldet den Trend, der zum Ausfall führt, und verhindert ihn damit überhaupt erst. Es sind meist die cloudbasierten Lösungen der Hersteller, die deine Umgebung gegen Fehlerbilder aus sehr vielen anderen Installationen halten.

Reaktives Monitoring meldet, dass etwas kaputt ist. Das sind meist die On-Premises-Systeme, und sie sind der Teil, auf den die Alarmierung aufsetzt.

Wer nur das zweite betreibt, erfährt zuverlässig vom Ausfall. Wer beides betreibt, erfährt vorher davon.

Was dazugehört

Überwacht werden Hardware, Anwendungen, Services und Netzwerke, rund um die Uhr und ohne Agenten auf den Systemen. Ein Dashboard zeigt den Zustand der Infrastruktur, die Alarmierung geht per E-Mail und SMS, und ein Alarm eröffnet automatisch ein Ticket beim Service Desk und, wo nötig, beim Hersteller.

Womit

Mit den Produkten unserer Partner, oder mit Open-Source-Produkten, wenn die besser passen. Was passt, hängt davon ab, welche Schnittstellen deine Systeme schon bedienen.

Worauf zu achten ist

Vor der Einführung klären wir, welche Meldung wen erreicht und was daraufhin passiert. Alarme ohne festgelegte Reaktion werden nach kurzer Zeit ignoriert, und dann fehlen sie im Ernstfall.
Expertinnen und Experten dafür

Vielleicht du? Schau dir unsere offenen Chancen an.

Passt ausserdem